Langfuse:LLM 应用的可观测性平台
LLM 应用上线后,开发者很快会意识到:一次用户请求往往要经过提示词组装、多轮模型调用、RAG 检索、工具调用和 Agent 决策等多个环节。出了问题时,只看到最终输出错误,却难以定位是哪一步偏离了预期。Langfuse 正是为解决这类「黑盒」问题而生的开源可观测性平台。
什么是 Langfuse
Langfuse 是一个开源的 LLM 工程与 LLMOps 可观测性平台,专为大语言模型应用和 AI 智能体(Agents)的开发、监控、调试与优化而设计。它以 Tracing(追踪) 为核心,把单次请求内部的每一次模型调用、工具执行、检索结果和状态变化都记录成结构化的 Trace,让团队能够像排查传统微服务一样排查 LLM 链路。
与同样面向 LLM 可观测性的 LangSmith 相比,Langfuse 最大的区别在于开源与自托管。LangSmith 是 LangChain 团队提供的闭源 SaaS 服务,功能强大但超出免费额度后需要按量付费,且无法完整部署到私有环境中。Langfuse 则采用 MIT 协议 完全开源,代码公开可审计;你可以选择官方托管的 Langfuse Cloud,也可以免费在自己的服务器上私有化部署,数据主权和成本完全可控。
项目提供两种方式使用:
- Langfuse Cloud:官方托管的 SaaS 版本,适合快速上手或小团队。
- Self-Hosted:通过 Docker Compose 或 Kubernetes 私有化部署,无需向 Langfuse 支付授权费用,数据完全留在自己的基础设施里。
无论是直接调用 OpenAI / Anthropic / 本地模型,还是通过 LangChain、LlamaIndex、OpenTelemetry 等框架接入,Langfuse 都能以较低的侵入性捕获关键遥测数据。
核心特性
Langfuse 的功能围绕「可观测、可评估、可迭代」三条主线展开,主要模块如下。
Tracing(追踪)
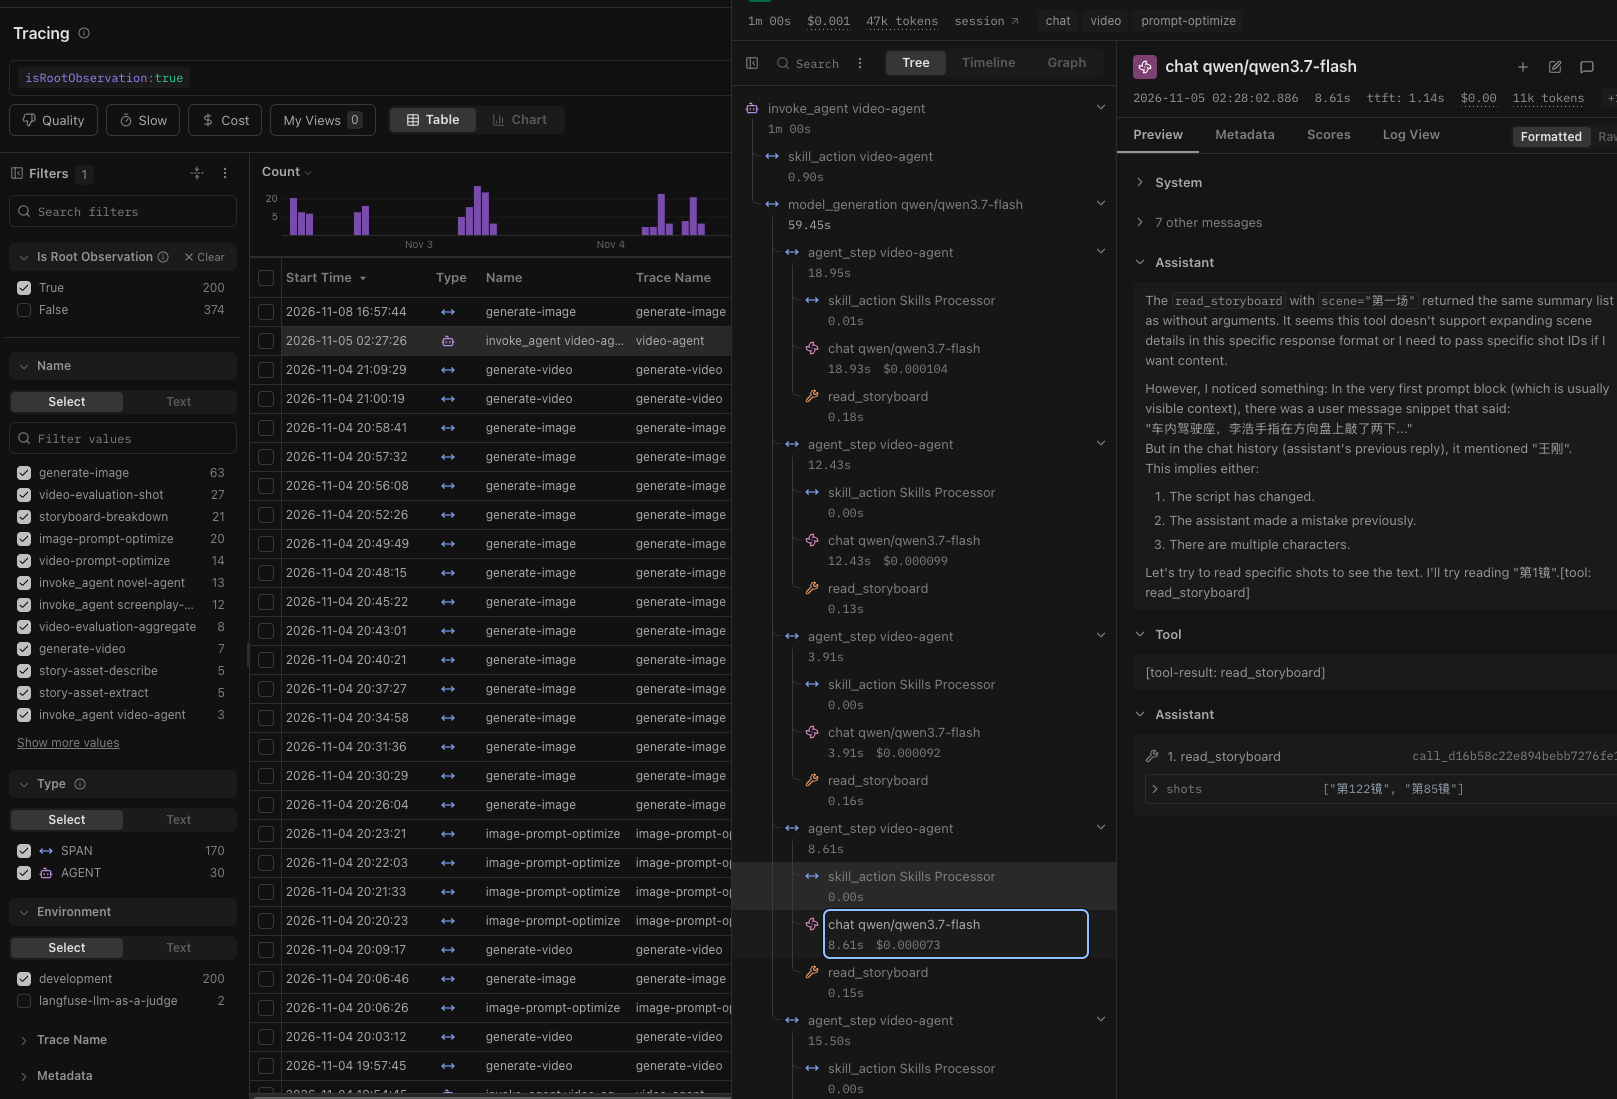
Tracing 是 Langfuse 的底座。每个用户请求对应一条 Trace,内部按时间线拆成多个 Span 和 Generation:
- Generation:记录一次 LLM 调用,包括输入提示词、模型参数、输出内容、Token 用量和延迟。
- Span:记录任意业务步骤,如 RAG 检索、工具调用、知识库查询等。
- Event:记录关键事件,如用户反馈、错误异常。
通过嵌套结构,开发者可以清晰看到请求在各阶段的耗时、成本和中间状态,快速定位幻觉、超时或检索失败。
Metrics(指标)
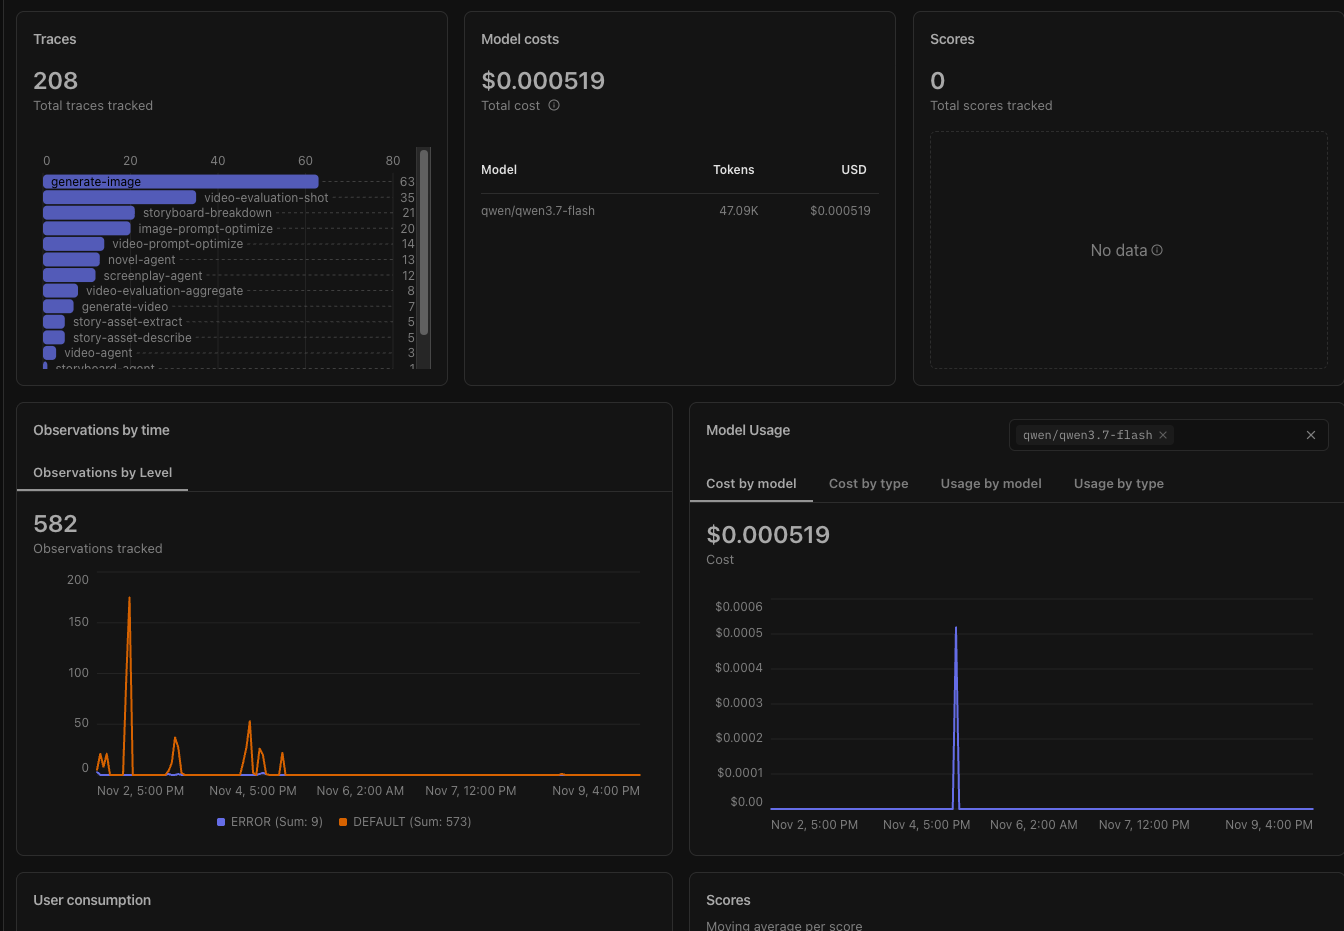
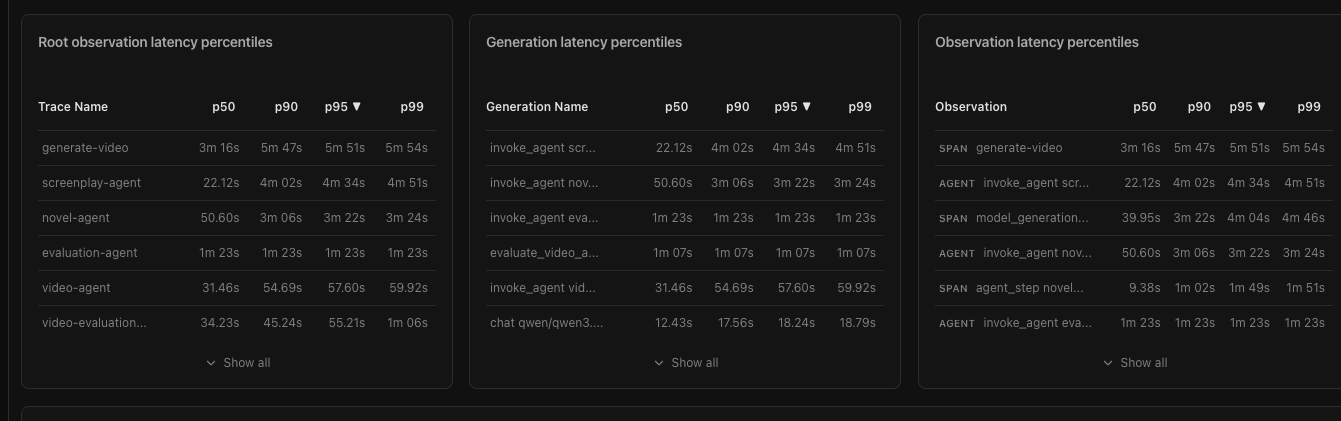
平台会自动聚合 Trace 中的数据,生成可观测指标:
- Token 消耗与预估成本
- 延迟分布(P50 / P95 / P99)
- 错误率与调用成功率
- 模型使用分布
这些指标既可以在 Dashboard 中查看,也支持通过 API 导出到现有的 Prometheus / Grafana 或 BI 体系。
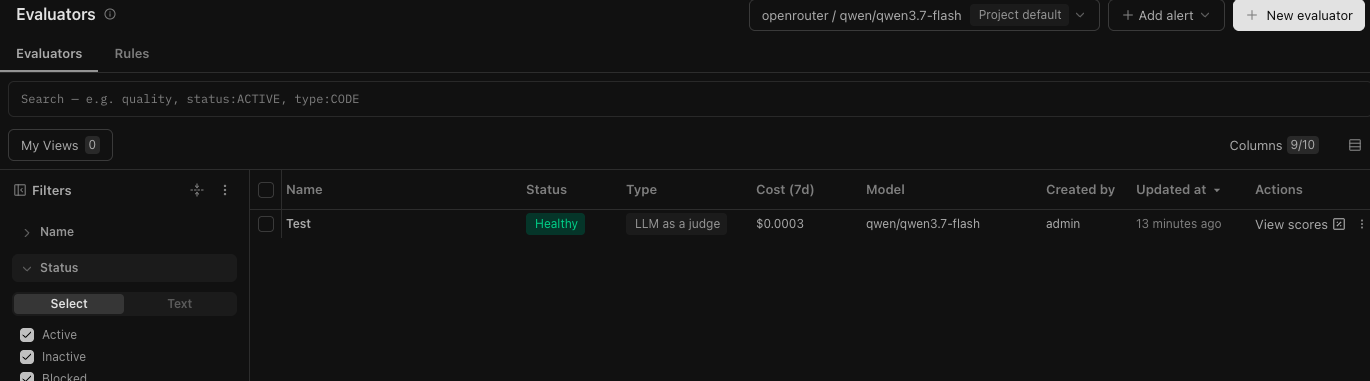
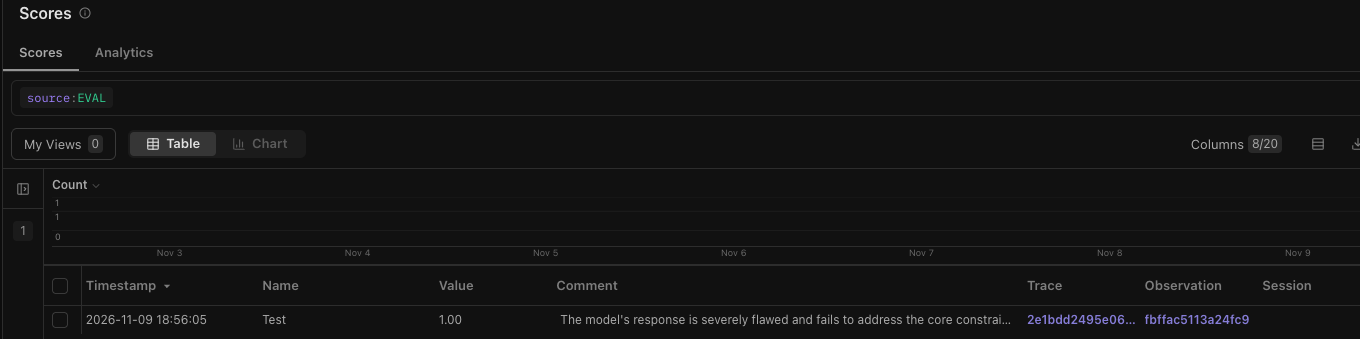
Evals(评估)
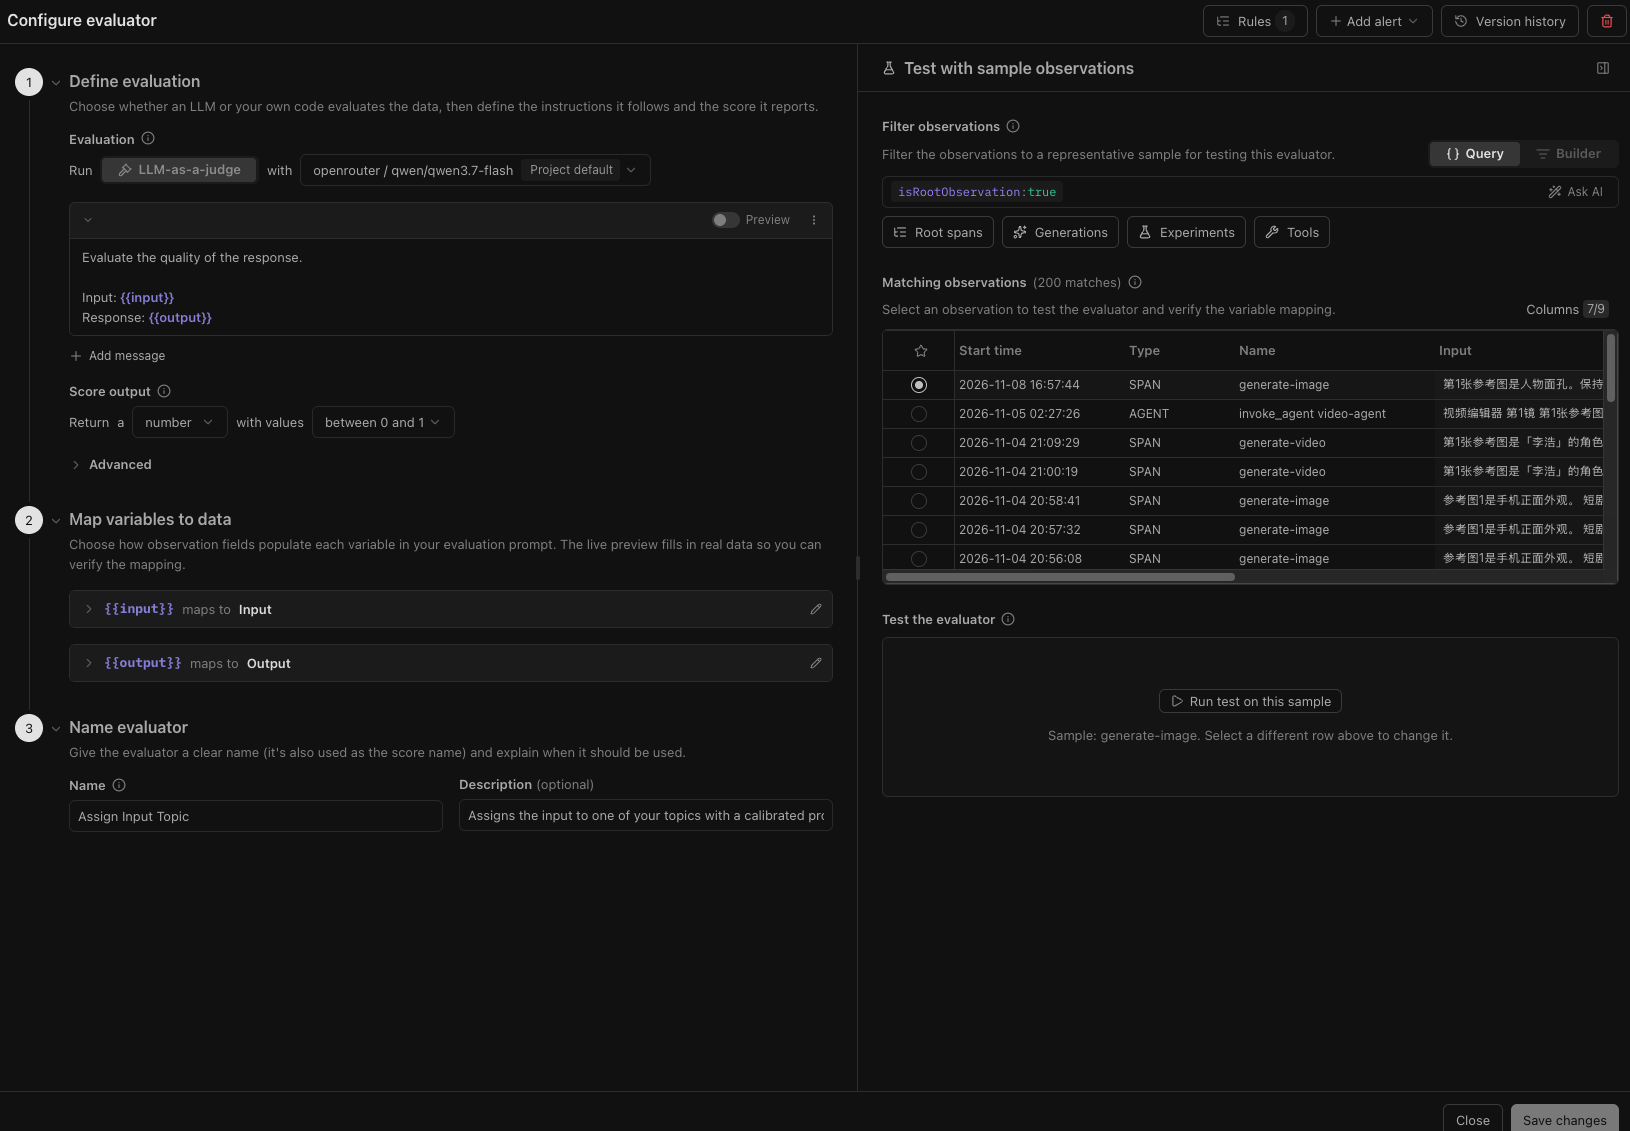
Langfuse 把评估分为两类:
- 在线评估(Online):生产流量到达后,通过规则、LLM-as-a-judge 或自定义函数自动打分,并关联到具体 Trace。
- 离线评估(Offline):基于数据集批量运行评测,用于回归测试、A/B 对比和提示词版本对比。
评估结果以 Score 形式挂在 Trace 或 Generation 上,方便团队量化模型表现并追踪趋势。
Prompt Management(提示词管理)
Langfuse 提供版本化的提示词管理:
- 在界面中创建、编辑和版本控制提示词模板。
- 在代码中通过
prompt_name和version调用,避免提示词散落在各处。 - 提示词改动可直接关联到 Trace,便于观察版本变化对输出的影响。
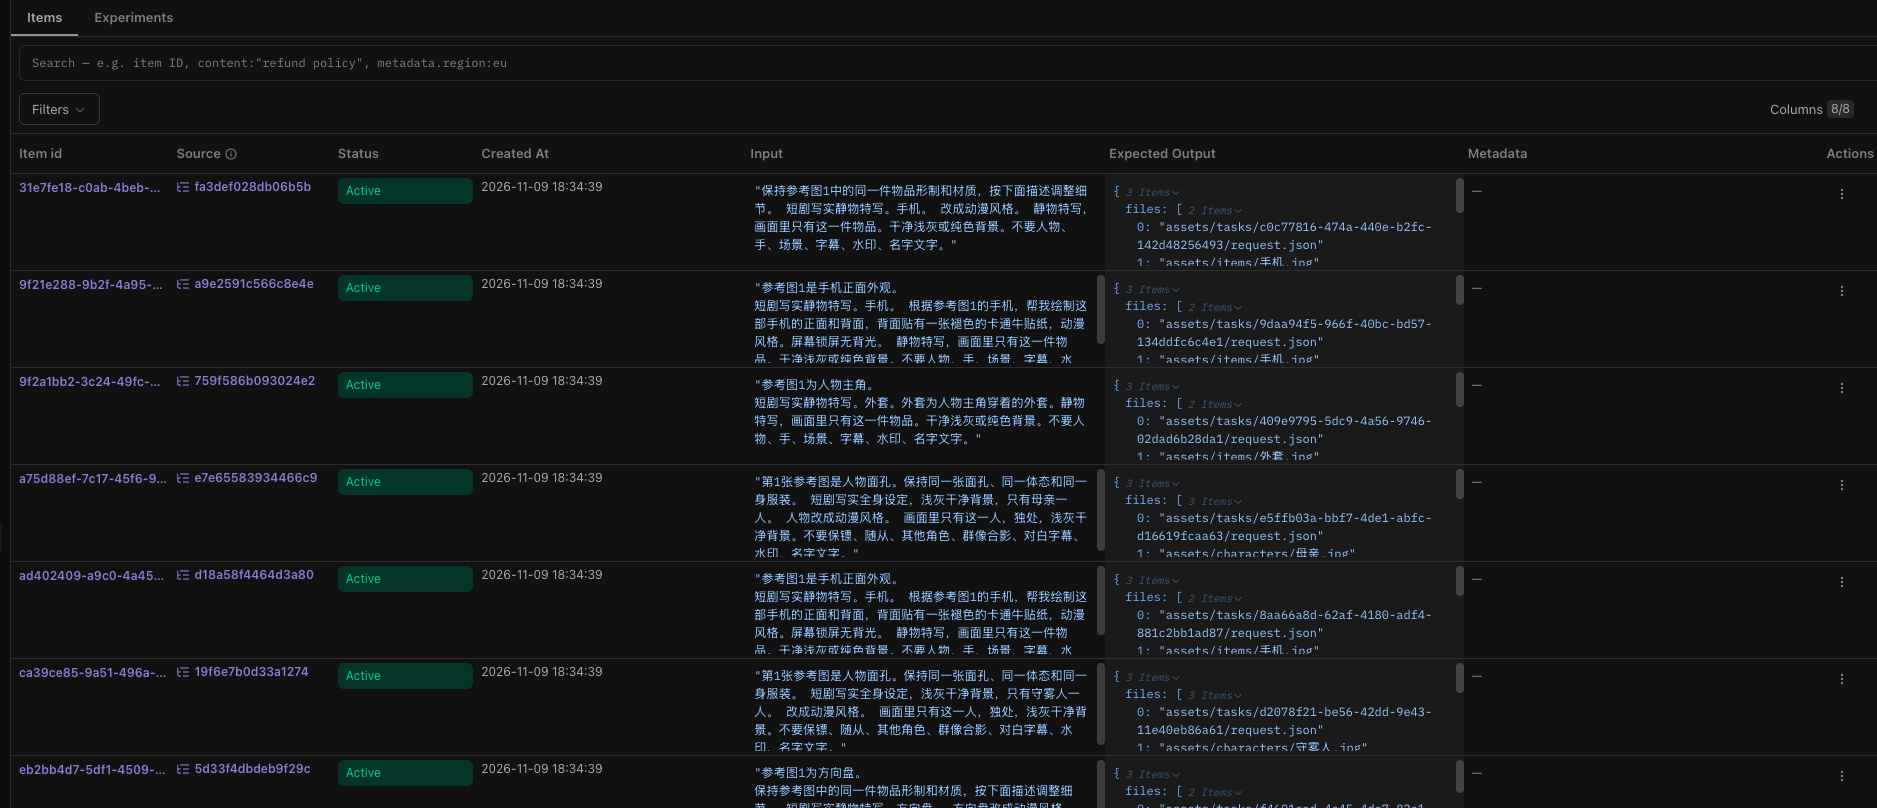
Datasets(数据集)
Datasets 用于构建测试集和基准:
- 从生产 Trace 中一键挑选 bad case 加入数据集。
- 批量运行相同输入,对比不同模型或提示词版本的表现。
- 与 CI 结合,实现提示词或模型变更前的自动回归测试。
安装部署
Langfuse 的私有化部署以 Docker 为主。以下介绍本地快速体验和生产部署的核心思路;具体镜像版本和完整变量列表建议以官方文档为准。
本地快速启动
官方推荐用 Docker Compose 一键拉起。一个最小化的本地栈通常包含以下服务:
langfuse-web:Web 界面与 API 入口。langfuse-worker:后台任务处理(如批量写入、评估任务)。postgres:元数据与项目数据存储。clickhouse:Trace 与事件数据存储。redis:任务队列与缓存。minio:S3 兼容的对象存储(用于上传文件、图片等)。
准备 .env 文件:
# 数据库
DATABASE_URL=postgresql://postgres:postgres@postgres:5432/langfuse

# 分布式存储与队列
CLICKHOUSE_URL=http://clickhouse:8123
REDIS_URL=redis://redis:6379

# S3 兼容对象存储
S3_ENDPOINT=http://minio:9000
S3_BUCKET=langfuse
S3_ACCESS_KEY_ID=minio
S3_SECRET_ACCESS_KEY=miniosecret

# 安全与加密(生产环境务必使用强随机字符串)
NEXTAUTH_URL=http://localhost:3000
NEXTAUTH_SECRET=your-nextauth-secret
SALT=your-salt
ENCRYPTION_KEY=your-encryption-key
然后在同一目录下启动:
docker compose up -d
服务启动后,访问 http://localhost:3000 完成初始化并创建第一个项目。
关键环境变量说明
| 变量 | 作用 |
|---|---|
DATABASE_URL |
PostgreSQL 连接串,存储用户、项目、提示词等元数据。 |
CLICKHOUSE_URL |
ClickHouse 连接串,存储大规模 Trace 和事件。 |
REDIS_URL |
Redis 连接串,用于队列和缓存。 |
S3_* |
对象存储配置,Trace 附件、数据集文件等依赖它。 |
NEXTAUTH_SECRET / SALT / ENCRYPTION_KEY |
会话、密码哈希与数据加密的密钥,生产环境必须用强随机值。 |
NEXTAUTH_URL |
登录回调地址,需与外部访问地址一致。 |
生产部署注意事项
从本地体验过渡到生产时,建议重点关注以下几点:
- 外部数据库与对象存储:使用托管的 PostgreSQL、Redis 和 S3 服务,避免把状态卷在容器内。
- 持久化与备份:ClickHouse 和 PostgreSQL 数据需要定期备份,尤其是 Trace 数据增长较快。
- 高可用:
langfuse-web和langfuse-worker可以水平扩展;数据库和对象存储本身需独立做高可用。 - 安全:
- 所有加密密钥(
NEXTAUTH_SECRET、SALT、ENCRYPTION_KEY)都应通过 Secrets 管理,避免写入 Git。 - 为 Web 服务配置 HTTPS 和合适的访问控制。
- 所有加密密钥(
- 资源规划:Trace 数据量随流量线性增长,需根据保留策略规划 ClickHouse 与对象存储容量。
如果团队没有运维 Kubernetes 的经验,Langfuse Cloud 是更省心的选择;它提供相同的功能,只是把基础设施托管给官方。
基本使用
Langfuse 提供 Python 和 TypeScript/JavaScript SDK,也支持通过 OpenTelemetry、LangChain、LlamaIndex 等框架自动接入。这里以 Python SDK 为例,展示最小可运行的接入流程。
获取 API Key
在 Langfuse Web 界面中进入项目设置,创建一对 Public Key / Secret Key。本地部署时 host 为 http://localhost:3000,使用 Cloud 时则为 https://cloud.langfuse.com。
安装 SDK
pip install langfuse
方式一:直接调用 SDK
适合想精确控制 Trace 结构的场景:
import os
from langfuse import Langfuse

langfuse = Langfuse(
    public_key=os.getenv("LANGFUSE_PUBLIC_KEY"),
    secret_key=os.getenv("LANGFUSE_SECRET_KEY"),
    host=os.getenv("LANGFUSE_HOST", "http://localhost:3000"),
)

# 创建一条 Trace
trace = langfuse.trace(
    name="qa-session",
    user_id="user-123",
    metadata={"source": "web"},
)

# 记录一次 LLM 调用(Generation)
trace.generation(
    name="openai-answer",
    model="gpt-4o-mini",
    input=[{"role": "user", "content": "什么是 Langfuse?"}],
    output={"role": "assistant", "content": "Langfuse 是一个开源的 LLM 可观测性平台。"},
    usage={"input": 12, "output": 18, "unit": "TOKENS"},
)

# 记录业务步骤(Span)
with trace.span(name="retrieve-docs") as span:
    docs = ["doc-1", "doc-2"]
    span.update(output={"retrieved": docs})

# 确保事件在程序退出前上报
langfuse.flush()
方式二:装饰器自动追踪
如果代码已经直接调用 OpenAI,可以用 @observe() 装饰器几乎无侵入地接入:
import os
from langfuse.decorators import observe
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

@observe()
def answer(question: str) -> str:
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": question}],
    )
    return response.choices[0].message.content

answer("什么是 Langfuse?")
装饰器会自动为 answer 函数生成 Trace,内部的 LLM 调用生成 Generation,输出、延迟和 Token 用量都会被记录下来。
在 Dashboard 中查看
运行上述代码后,回到 Langfuse Web 界面,进入对应项目即可看到:
- Traces:按时间线列出所有请求,点击可展开完整的调用链。
- Generations:聚合所有 LLM 调用,支持按模型、延迟、成本筛选。
- Scores:手动或自动为 Trace 打分,追踪质量趋势。
- Dashboards:查看 Token 消耗、延迟分布、错误率等聚合指标。
从一条 Trace 出发,开发者可以逐层下钻到具体 Generation,查看当时的提示词、模型参数和原始输出,从而快速定位问题根因。
总结
适用场景
Langfuse 最适合以下几类 LLM 应用:
- RAG 应用:需要追踪检索结果、重排序、上下文拼接与最终生成之间的关联。
- Agent 系统:Agent 会多次调用模型、工具或外部 API,Trace 能帮你看清每一步决策与状态。
- 多模型策略:同时调用多个模型或做模型降级时,需要对比延迟、成本与输出质量。
- 成本敏感业务:希望按用户、按会话追踪 Token 消耗,识别异常流量或高成本调用。
- 持续迭代团队:需要把提示词版本、评估分数与线上反馈串起来,形成迭代闭环。
与同类工具的差异
市面上类似的 LLM 可观测性工具不少,例如 LangSmith、Phoenix(Arize)、Weights & Biases 等。Langfuse 的主要差异在于:
- 开源且可私有化:MIT 协议,支持 Docker 和 Kubernetes 自托管,数据主权完全可控。
- 以 Tracing 为核心:Trace 结构清晰,Generation、Span、Event 分层明确,便于下钻排查。
- 功能一体化:观测(Tracing/Metrics)、评估(Evals)、提示词管理、数据集测试集中在同一平台,减少工具链割裂。
- 框架无关:除了官方 SDK,也支持 OpenTelemetry、LangChain、LlamaIndex、Vercel AI SDK 等多种接入方式。
上手建议
对于刚接触 Langfuse 的团队,建议按以下顺序推进:
- 先用 Cloud 验证:注册 Langfuse Cloud,花 30 分钟接入一个真实接口,确认 Trace 数据符合预期。
- 覆盖关键路径:为生产环境的核心调用链路加上 SDK 或装饰器,先把「能看」的问题解决。
- 补齐元数据:在 Trace 中携带
user_id、session_id、metadata,方便后续按用户或会话聚合。 - 引入评估:从简单的规则打分或 LLM-as-a-judge 开始,逐步建立质量基线。
- 管理提示词版本:把关键提示词迁到 Langfuse Prompt Management,关联 Trace 观察版本影响。
- 再考虑私有化:当数据合规、成本或自定义需求明确时,再切到 Self-Hosted 部署。
Langfuse 不是「安装完就自动解决问题」的工具,它提供的是一套结构化的观测语言。真正发挥价值,需要团队把 Trace、Eval 和 Prompt 管理融入到日常开发与迭代流程中。